GPT-5.6 Sol·Terra와 GPT-6 Astra, 어떤 모델이 가장 효율적일까?
같은 질문을 세 가지 설정에 던졌더니 결론은 비슷했지만, 자료를 찾고 판단을 만드는 방식은 달랐습니다.
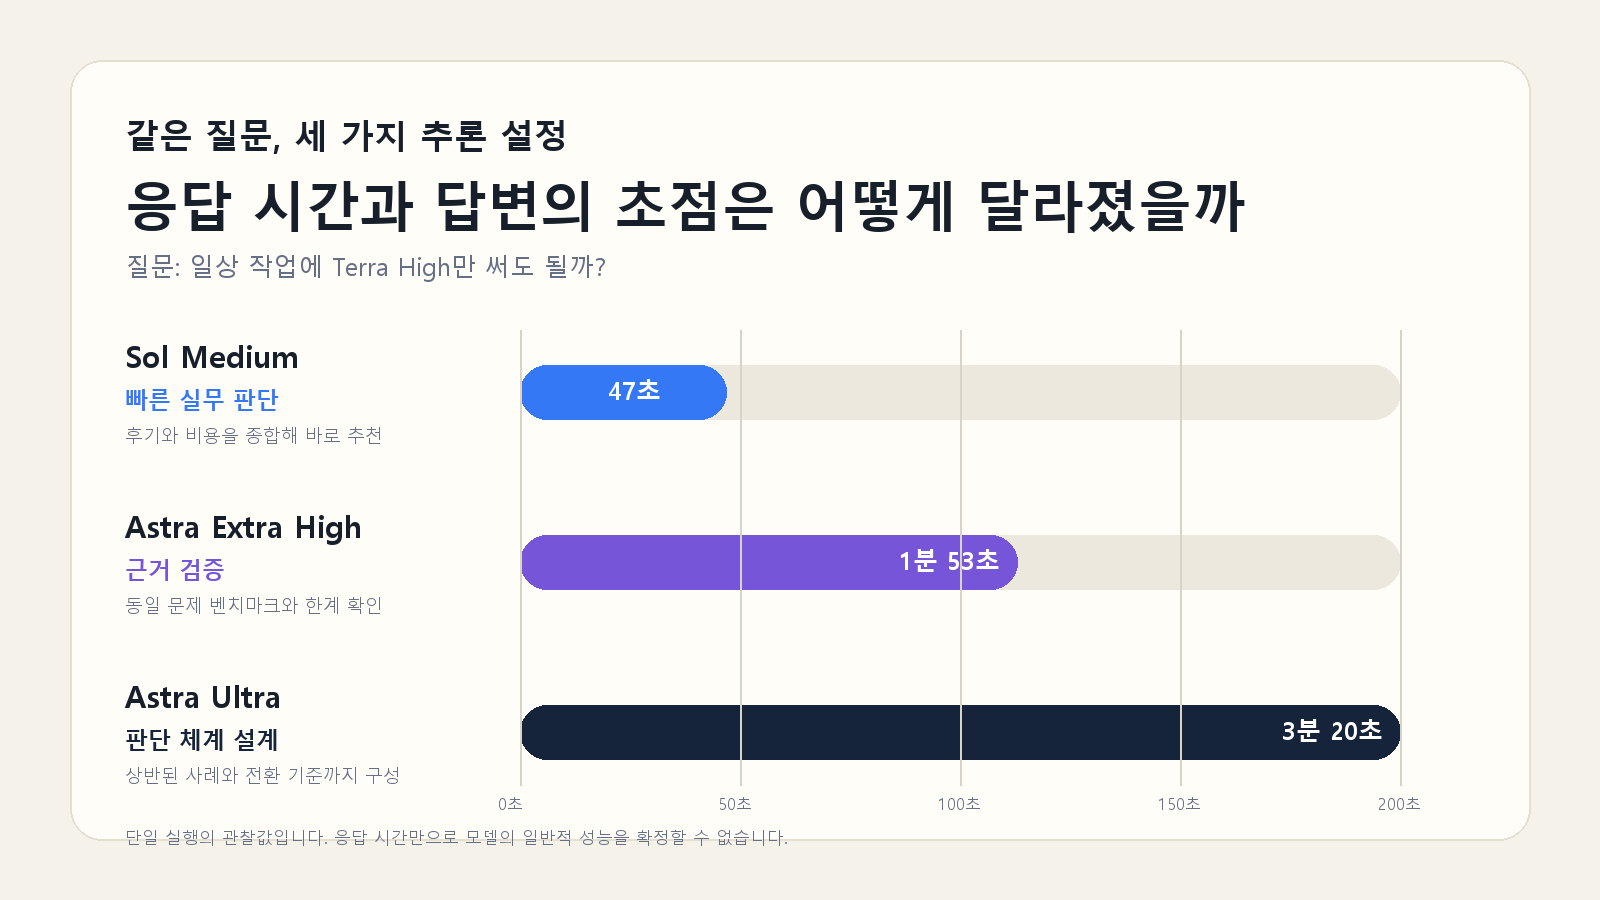
질문은 간단했습니다. “평소에는 Terra High만 써도 될까?” Sol Medium은 47초, Astra Extra High는 1분 53초, Astra Ultra는 3분 20초가 걸렸습니다. 가장 느린 Ultra는 Sol Medium보다 약 4.3배 오래 걸렸습니다.
하지만 오래 걸린 답이 모든 면에서 우수했던 것은 아닙니다. 세 답변은 같은 결론에 도달하면서 서로 다른 가치를 만들었습니다.
47초의 Sol Medium: 가장 빨리 쓸 수 있는 답
Sol Medium은 Reddit의 사용 경험과 비용 사례를 모아 곧바로 작업별 추천을 제시했습니다. 일상 작업은 Terra High, 복잡한 설계와 디버깅은 Sol이나 Astra로 올리라는 결론이었습니다.
답변은 간결했고 바로 적용할 수 있었습니다. 반면 Terra High와 Sol Medium처럼 작업 성격에 따라 우위가 달라지는 조합을 하나의 성능 순서처럼 정리하는 경향도 있었습니다.
관련 근거 OpenAI 모델 비교 · Sol Medium과 High 사용자 토론
1분 53초의 Astra Extra High: 결론보다 근거를 검증했다
Astra Extra High는 “추론 단계를 올리면 실제 성능도 좋아지는가”를 보여줄 수치 자료를 더 적극적으로 찾았습니다. 동일한 98개 문제를 사용한 개인 실험에서 Medium은 91개, High와 Extra High는 각각 95개를 맞혔습니다.
이 결과만 보면 Medium에서 High로 올렸을 때는 향상이 있었지만, Extra High에서는 점수가 더 오르지 않았습니다. 특정 문제집을 한 번 실행한 결과이므로 일반적인 코딩 성능으로 확대할 수는 없지만, 높은 추론 단계의 수익이 항상 비례하지 않는다는 사례는 됩니다.
관련 근거 Astra 추론 단계 98문제 비교 · OpenAI 모델 가이드
3분 20초의 Astra Ultra: 답이 아니라 선택 기준을 만들었다
Astra Ultra는 자료를 더 넓게 찾고, 서로 반대되는 사용자 경험도 함께 배치했습니다. 또한 모델 선택과 추론 단계를 분리했습니다. Terra·Sol·Astra는 모델의 성격이고, Medium·High·Ultra는 한 작업에 투입하는 추론과 실행 방식이라는 설명입니다.
가장 좋은 제안은 설정을 올리는 기준이었습니다. 답변 길이나 생각한 시간이 아니라, 빠뜨린 요구사항과 사람이 다시 고쳐야 하는 양을 보라는 것입니다. 다만 자료의 폭은 넓어졌어도 개인 경험의 비중이 커서, 근거 하나하나가 더 강해졌다고 보기는 어렵습니다.
관련 근거 OpenAI 모델 선택 설명 · Sol Ultra 사용자 경험
그래서 어떤 모델이 가장 효율적일까?
이번 비교에서 세 설정은 다음과 같은 역할 차이를 보였습니다.
Sol Medium: 빠른 조사, 초안 작성, 일상적인 의사결정
Astra Extra High: 중요한 주장과 비교 수치를 검증할 때
Astra Ultra: 자료가 충돌하거나 복잡한 선택 기준을 설계할 때
Sol Medium은 답을 만들었고, Astra Extra High는 답을 검증했으며, Astra Ultra는 답을 사용할 규칙까지 만들었습니다.
효율만 보면 Sol Medium이 가장 좋았습니다. 중요한 대외 자료나 실패 비용이 큰 판단에서는 Astra Extra High가 추가 시간을 쓸 이유가 있었습니다. Ultra는 여러 자료와 관점이 충돌하고, 작업을 나눠 검토할 수 있을 때 선택하는 편이 맞았습니다.
이 비교는 각 설정을 한 번씩 실행한 관찰 기록입니다. 응답 시간은 검색 상황과 대화 맥락에 따라 달라질 수 있으므로 모델의 보편적인 속도나 품질을 확정하는 벤치마크로 해석해서는 안 됩니다.
관련 근거 OpenAI 모델 비교 · 11일간 Codex 사용 기록
출처 및 참고
OpenAI 모델 비교
OpenAI 모델 가이드
Astra 추론 단계 비교 실험
11일간 Codex 사용 기록